Senticor · Piloto
openDesk: operación multicloud y controles de recuperación
Un piloto de Senticor para openDesk, una suite de oficina y colaboración de código abierto. Combina aplicaciones que pueden reconstruirse, datos conservados, recepción de correo independiente y controles para actualizaciones y apagados.
Situación: elegir software implica asumir su operación
Un puesto de trabajo de código abierto reúne servicios que comparten identidad, almacenamiento y correo. Elegir las aplicaciones deja una segunda decisión: quién gestiona su ciclo de vida y cómo preservar los datos y la comunicación durante los cambios.
- Microsoft 365 y Google Workspace combinan productos de oficina y comunicación como servicios en la nube.
- Nextcloud Hub reúne archivos, edición colaborativa y comunicación, con opción de alojamiento propio.
- openDesk integra aplicaciones de trabajo de código abierto. Community permite operación propia; las administraciones públicas también disponen de soporte Enterprise y distintos modelos operativos.
El piloto de Senticor contemplaba pausas programadas de las aplicaciones. Coordinar sus ciclos de vida era un problema concreto de ingeniería: la capacidad de ejecución podía reconstruirse, pero documentos, identidades y correo no podían tratarse como infraestructura desechable.
Tarea y mi contribución
Mi trabajo abarcó automatización del ciclo de vida, controles de actualización, integración del correo y análisis de incidentes. El modelo separó las funciones que podían pausarse de las que debían continuar, y condicionó las operaciones destructivas a pruebas de que el estado conservado estaba protegido.
El alcance incluyó configuración de infraestructura, adaptaciones del despliegue, scripts operativos, comprobaciones y procedimientos. El compromiso aceptado fue una disponibilidad limitada en un piloto: conservar los datos tenía prioridad sobre el acceso ininterrumpido.
Acciones: controlar cambios entre servicios
Separar ejecución y estado persistente
Las aplicaciones y los buzones de openDesk funcionan en Google Kubernetes Engine. Terraform describe la infraestructura GCP; adaptaciones de Helmfile y scripts gestionan instalación y ciclo de vida. Los discos conservados y las instantáneas programadas de forma independiente sobreviven a las pausas. Un servidor STACKIT gestionado con Ansible recibe correo y controla arranque y parada. Ese servidor permanente queda deliberadamente fuera del ciclo de vida de Terraform.
Tratar una actualización como un cambio en las relaciones de datos
La actualización pasó por una versión intermedia. Comparar las configuraciones generadas permitió revisar asignaciones de almacenamiento persistente, plantillas de servicios con estado e interfaces de correo. Un nuevo valor predeterminado habría elegido otro almacenamiento de objetos al reconstruir desde cero. Mantener MinIO explícitamente conservó la conexión con el almacenamiento existente, en lugar de crear uno vacío.
Decidir por separado continuidad del correo y apagado
Un receptor MX independiente acepta y encola mensajes mientras las aplicaciones están pausadas. Mantiene la recepción, no el acceso al buzón. Antes del apagado deben vaciarse las colas SMTP de las aplicaciones, detenerse los procesos que escriben en ellas y verificarse que están realmente vacías. Una comprobación fallida o incierta bloquea el desmontaje; terminar un comando correctamente no basta para autorizarlo.
Investigar el acceso a través de las dependencias
Tras un reinicio, una aplicación de correo sana quedó oculta detrás del control público de disponibilidad. Corregir la selección y las transiciones de estado restauró el acceso. Otra investigación relacionó problemas de portal y correo con saturación del servicio de identidad compartido. Estos casos aportaron comprobaciones de acceso y entrega de extremo a extremo, además de la salud de cada componente.
Resultados: controles implementados y comportamiento observado
Implementado
El piloto dispone de un ciclo de vida documentado entre dos proveedores, controles para actualizaciones por etapas, instantáneas independientes y una condición de vaciado de correo antes de desmontar la ejecución. Un incidente evitado durante la limpieza de discos conservados también dio lugar a comprobaciones de inventario que rechazan eliminaciones inciertas y a pruebas de regresión.
Verificado en los registros operativos
Los registros documentan una actualización aplicada, acceso público e inicio de sesión recuperados tras corregir el control, un conjunto completo de instantáneas listas y preparación, inspección sin procesos activos y reanudación de los servicios de correo. Son observaciones concretas, no una confirmación de todos los escenarios de recuperación.
Límite operativo
Sigue siendo un piloto con interrupciones aceptadas. El único receptor MX tiene retención limitada; no es redundante ni está cubierto por las instantáneas GCP. Estas copian discos individuales y no demuestran una restauración coherente de toda la aplicación. Falta una restauración completa y aislada. GCP y Cloudflare siguen siendo dependencias; no se afirma soberanía completa, ahorro ni mejora de disponibilidad.
Lecciones para decisiones de plataforma
- Definir los ciclos antes de automatizar eliminaciones: Ejecución, estado persistente, colas y requisitos de recuperación tienen vidas diferentes. La automatización necesita inventario explícito y condiciones que le obliguen a detenerse.
- Validar interfaces durante las actualizaciones: Un despliegue correcto no basta cuando cambian almacenamiento o interfaces. Los datos existentes deben seguir accesibles tras actualizar y tras reconstruir.
- Distinguir objetivos de servicio: Correo aceptado, reenviado y legible son estados diferentes. Un único indicador oculta sus dependencias y formas de fallo.
- Demostrar la recuperación: Tener instantáneas, cumplir los requisitos y recuperar las aplicaciones son evidencias diferentes. La adopción productiva necesita la prueba pendiente y objetivos de servicio explícitos.
Proyecto y contexto
El caso se basa en los registros operativos del piloto de Senticor. Los productos enlazados aportan contexto de mercado; no se realizó una prueba comparativa de productos.
Arquitectura: ejecución, datos y condiciones de apagado
La topología separa recepción de correo, aplicaciones y datos duraderos. Un flujo de control muestra las comprobaciones necesarias antes de retirar el entorno de ejecución.

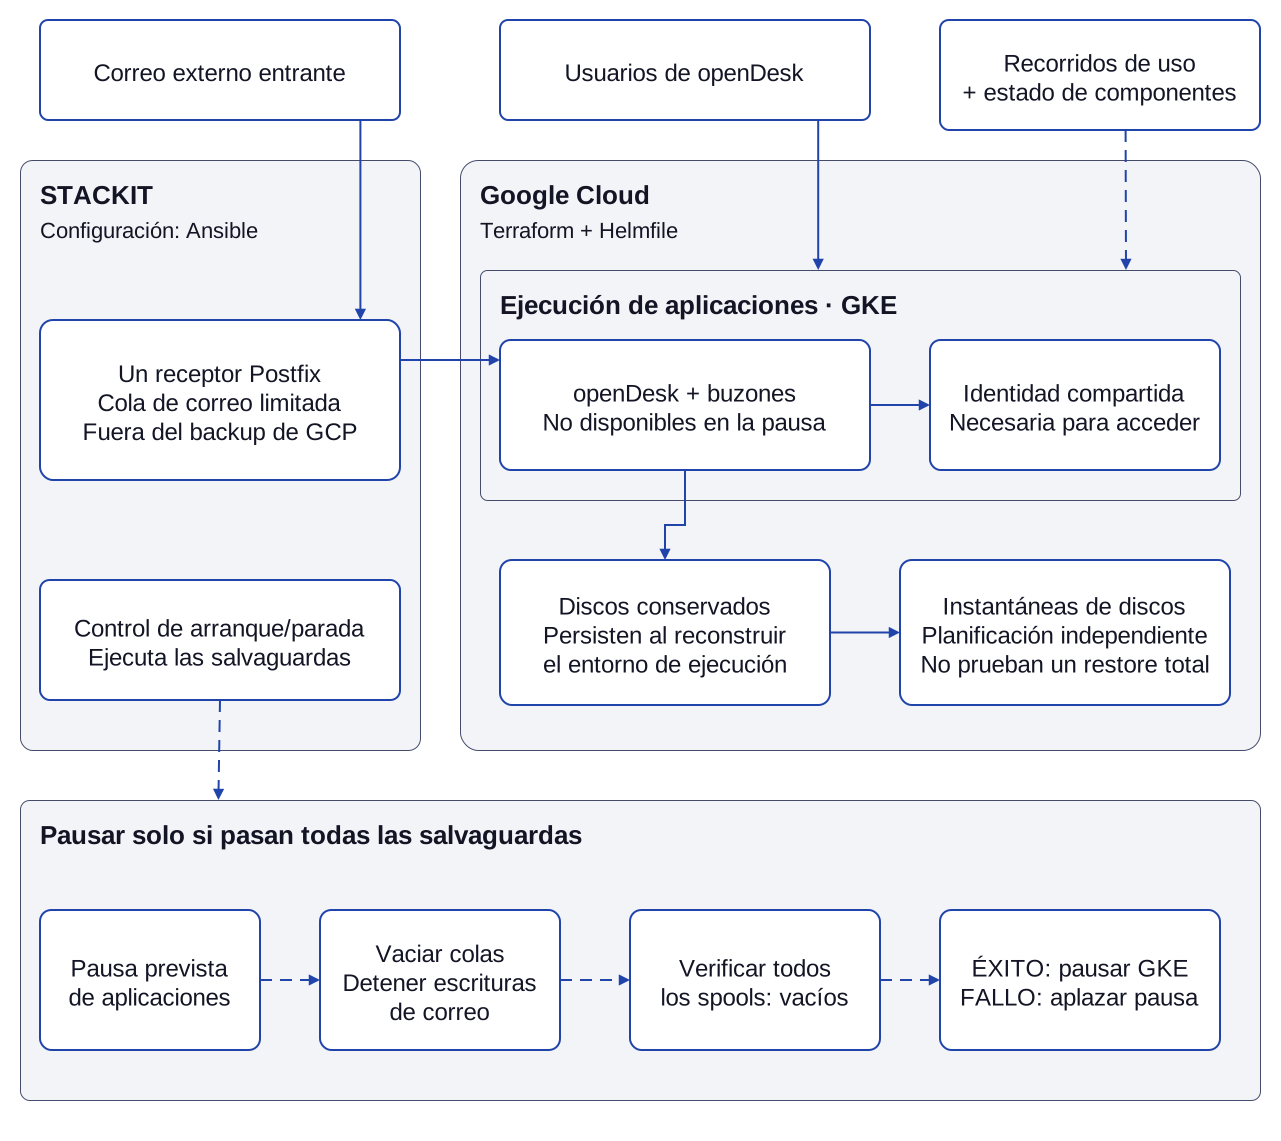
Descripción textual del diagrama
- STACKIT opera la recepción independiente de correo y el control de ejecución. La cola puede retener mensajes durante las pausas mientras ese único receptor esté disponible.
- Google Kubernetes Engine ejecuta aplicaciones y buzones de openDesk. La identidad es una dependencia compartida; los discos persistentes conservan datos más allá de la ejecución.
- La configuración de infraestructura y despliegue permite revisar los cambios. El host retenido de STACKIT tiene un ciclo de vida separado. Las instantáneas independientes protegen discos, sin demostrar un punto de recuperación coherente de toda la aplicación.
- Antes del apagado hay que vaciar las colas SMTP de la aplicación, detener los procesos de escritura SMTP y comprobar las colas reales con los procesos de correo detenidos.
- Solo un estado seguro confirmado permite retirar la ejecución. Un fallo o una incertidumbre impide retirar la ejecución. La accesibilidad y el inicio de sesión requieren pruebas además del estado de los componentes.
Servicios y proyectos
Contacto
Envíe el proyecto, los requisitos y los plazos por correo electrónico.