Adobe · Produktführung
Adobe Ethos: Produktführung für eine interne Developerplattform
Eine interne Plattform verbindet Entwicklung, Deployment und Betrieb von Services über Cloud-Umgebungen hinweg. Meine Rolle: Lead PM / Group Product Manager.
Situation: Fragmentierte Entwicklungs- und Betriebsabläufe
Cloud-Infrastruktur stellt Rechenleistung und Speicher bereit. Eine interne Developerplattform muss auch organisatorische Fragen beantworten: Wie beginnt ein Team einen Service? Welchen Weg nimmt ein Deployment? Wer unterstützt den Betrieb und behebt einen Sicherheitsbefund? Unterschiedliche Antworten schaffen Abhängigkeiten zwischen Produktteams, Infrastruktur, Sicherheit und Betrieb.
Ethos verband diese Aufgaben bei Adobe. Das öffentlich beschriebene Modell bot direkten Plattformzugang und einen stärker standardisierten Deployment-Weg. Es wurde von Teams aus Creative Cloud, Document Cloud und Experience Cloud genutzt. Der Überblick im Adobe Tech Blog beschreibt dieses Modell.
Aufgabe: Den Entwicklungsablauf als Produkt behandeln
Ich war Lead PM / Group Product Manager für diese Developerplattform. Der Fall beschreibt die Arbeit der Plattform und des Teams.
Die Produktfrage lautet: Wo vermeidet Standardisierung wiederkehrende Arbeit, und wo brauchen Teams eigene Kontrolle? Eine nutzbare Plattform muss reguläre Deployments zusammenführen und die Serviceverantwortung erhalten. Akzeptanz, Supportaufwand und die Diagnose eines fehlgeschlagenen Deployments gehören ebenso dazu wie Infrastruktur.
Vorgehen: Delivery, Kontrollen und Verantwortung verbinden
- Ein vollständiger Serviceablauf: Die Architektur verbindet Einstieg, Quellcodeverwaltung, Deployment-Automatisierung und Laufzeit. Jeder Übergang ist eine Produktgrenze: Ein Team muss erkennen, was als Nächstes passiert, was fehlgeschlagen ist und wer es beheben kann.
- Sicherheit im Deployment: Adobe dokumentiert gehärtete Basis-Images, Build-Berechtigungen, Schwachstellenprüfungen, Secret-Anbindung und Netzwerkrichtlinien. Die Kontrollen sind Teil des Ablaufs; für die Behebung bleiben die Serviceteams verantwortlich. Adobes Sicherheitsbeschreibung erläutert die Umsetzung.
- Zuständigkeit unterhalb des Cloud-Kontos: Gemeinsam genutzte Infrastruktur kann die Verantwortung für einzelne Workloads verdecken. Adobes OpSec-Bericht beschreibt, wie gemeinsam mit Ethos und dem Serviceverzeichnis Zuordnung und Onboarding-Prüfungen ergänzt wurden, damit Befunde die Serviceverantwortlichen erreichen. Der OpSec-Bericht im Adobe Tech Blog erläutert Problem und Lösung.
- Gemeinsame Oberfläche, verteilte Beiträge: Ein Adobe-Beitrag auf der PlatformCon beschreibt die Zusammenführung interner Oberflächen und Beiträge aus verschiedenen Entwicklungsteams. Einheitliche Bedienung und klare Beitragsprozesse werden so Teil der Plattformarbeit. Der PlatformCon-Beitrag dokumentiert die Umsetzung.
Ergebnisse: Gemeinsame Delivery und zuordenbare Verantwortung
- Plattform im Betrieb: Die PlatformCon-Zusammenfassung beschreibt die bestehende Ethos-Infrastruktur über mehrere Regionen und den Ausbau zur breiteren Developerplattform. Laufender Betrieb und Ausbau der Developer Experience sind unterschiedliche Entwicklungsstufen.
- Zusammengeführte Developer Experience: Der PlatformCon-Beitrag beschreibt die Konsolidierung sechs interner Webanwendungen in einer Oberfläche, zu der Teams aus Adobe beitragen können.
- Bearbeitbare Sicherheitsbefunde: Der OpSec-Fall dokumentiert die Zuordnungsarbeit, damit Befunde das zuständige Produkt- oder Serviceteam erreichen statt ausschließlich den Plattformbetreiber.
Dies sind veröffentlichte Plattform- und Teamergebnisse. Die folgende Architektur rekonstruiert das beschriebene Modell; sie ist kein aktuelles Inventar der Adobe-Systeme. Vergleichbare Vorher-Nachher-Messwerte zu Kosten, Delivery-Zeit oder Verfügbarkeit sind in diesen Quellen nicht ausgewiesen.
Erkenntnisse für Plattforminvestitionen
- Den gesamten Ablauf bewerten: Ein Portal hilft dann, wenn der Weg von der Serviceanlage bis zur Störungsdiagnose über die beteiligten Systeme funktioniert.
- Verantwortung sichtbar machen: Zentraler Betrieb hebt Anwendungsverantwortung nicht auf. Die Servicedefinition braucht ausreichend Kontext für Support, Berechtigungen und Fehlerbehebung.
- Abstraktionen bewusst wählen: Ein unterstützter Standardweg reduziert Entscheidungen. Für Anforderungen außerhalb dieses Weges brauchen Teams einen geklärten Zugang.
- Das beabsichtigte Ergebnis messen: Onboarding-Zeit, Reibung bei Deployments, Supportbedarf und Zuständigkeit bei Befunden sind sinnvolle Prüffragen. Die Zahl der Cluster oder Portalaufrufe beantwortet sie nicht.
Dies sind meine Schlussfolgerungen aus dem Betriebsmodell. Der IDP-Workshop-Bericht im Adobe Tech Blog vertieft die Diskussion über Entwicklerabläufe, Auffindbarkeit und Erfolgsmessung.
Quellen und Anerkennung
Die zentrale Quelle ist der Beitrag Ethos und die Cloud-Native-Transformation bei Adobe, veröffentlicht im Adobe Tech Blog. Das Architekturdiagramm ist eine neue Zusammenstellung öffentlich beschriebener Zusammenhänge und keine Kopie der Abbildung im Artikel.
Weitere Quellen stehen direkt bei den jeweiligen Aussagen. Sie beschreiben unterschiedliche Teile der Plattform; Vorschläge aus der Community werden nicht als ausgelieferte Ethos-Funktionen dargestellt.
Architektur: Vom Entwicklerablauf zum Multicloud-Betrieb
Das konzeptionelle Modell verbindet Serviceanlage, Delivery, Sicherheitskontrollen und Betrieb. Die Darstellung zeigt technische Übergaben und gemeinsame Verantwortung über Produktteam, Plattform und Laufzeit hinweg.

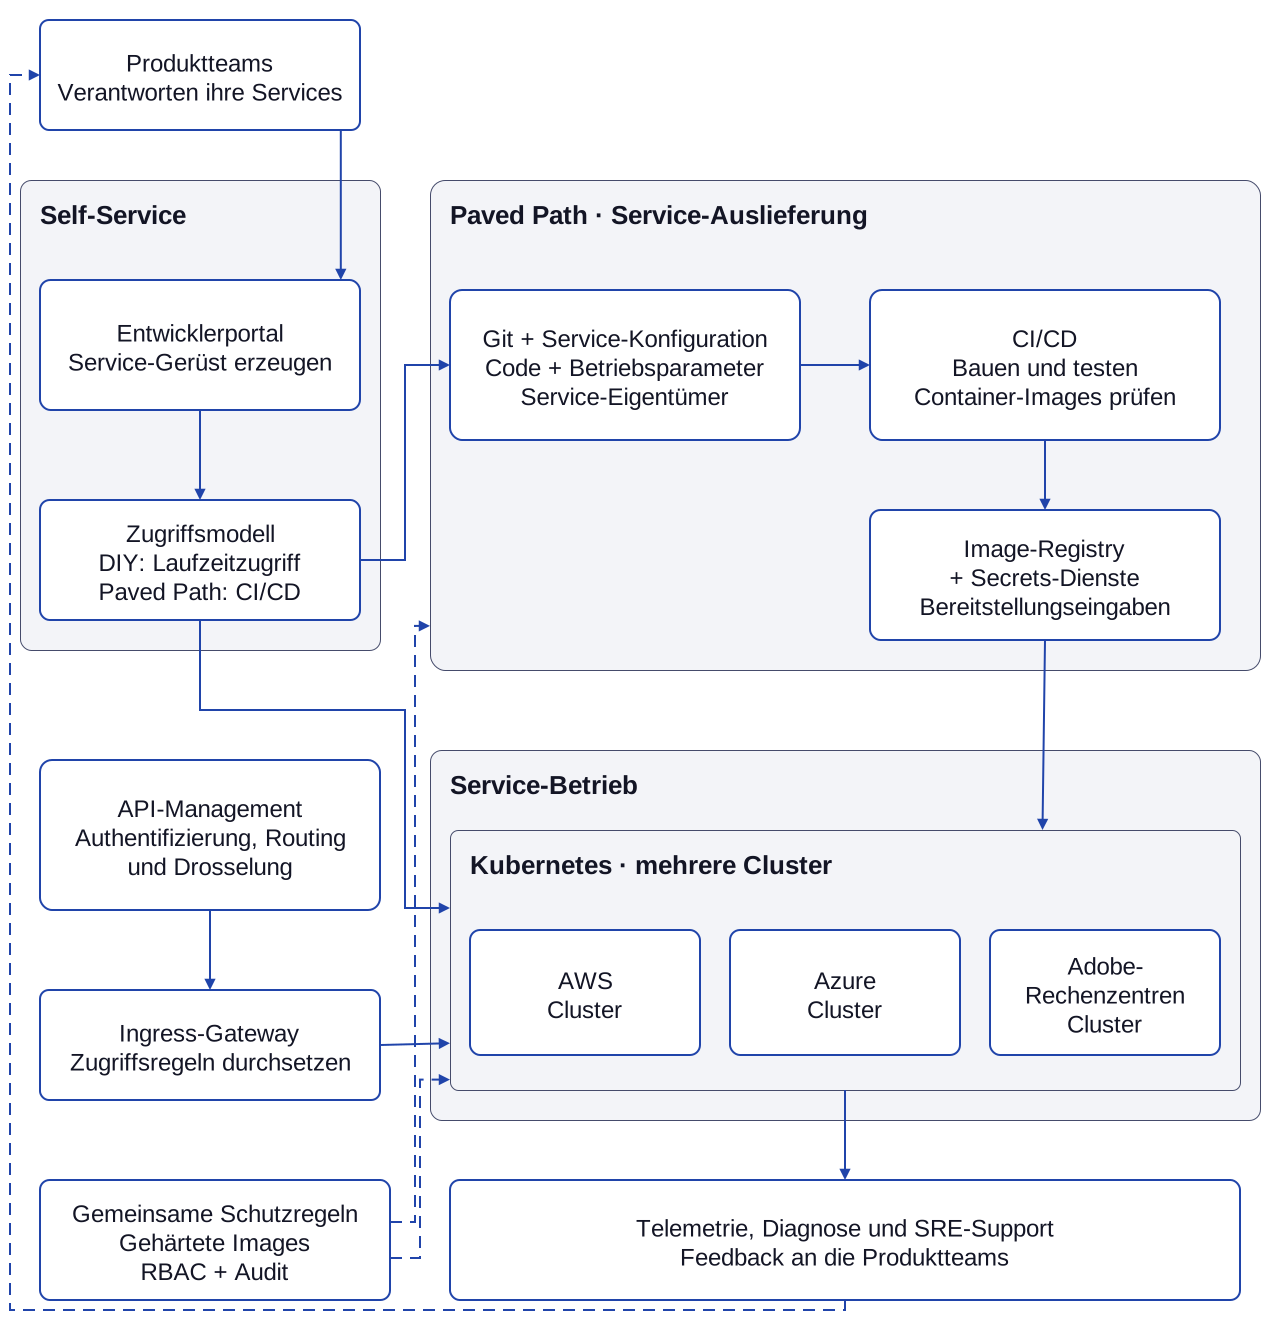
Textbeschreibung des Diagramms
- Produktteams beginnen mit Servicekonfiguration und Quellcode. Die Wege verzweigen: Der geführte Weg nutzt die gemeinsame Delivery; direkter Plattformzugang führt zur Laufzeit.
- Die Delivery verarbeitet Quellcode, Tests und Sicherheitsprüfungen. Images und Secrets haben eigene Ablagen; Berechtigungen und Verantwortung gehören zur Servicedefinition.
- Deployments erreichen Kubernetes-Umgebungen auf AWS, Azure und in Adobe-Rechenzentren. Die Darstellung behauptet keine identische Konfiguration jedes Dienstes oder automatische Ausfallsicherheit aller Anwendungen.
- Der Anwendungsverkehr ist vom Deployment getrennt. API-Management und Ingress übernehmen Routing sowie Zugriffs- und Ratenkontrollen.
- Diagnose und Betriebsdaten verbinden Service- und Plattformbetrieb. Gemeinsame technische Kontrollen ersetzen nicht die Zuständigkeit des Serviceteams für Anwendung und Fehlerbehebung.